这几天我做了一个很小但很顺手的东西:让 Codex 可以接手 Claude Code 没做完的任务,也让 Claude 可以接手 Codex 没做完的任务。
听起来像是在玩两个 AI 工具之间的套娃,但它解决的是一个很实际的问题。
我现在大量用 Claude Code 和 Codex 做代码任务。最常见的中断是 Claude 的 5 小时窗口用完了,但 Codex 这边还有额度,想切过去继续跑。中断本身不麻烦,麻烦的是回来以后,另一个工具不知道前面发生了什么。
以前最笨的办法是复制粘贴上下文:我把上一个工具最后几段对话、当前改了哪些文件、做到哪一步,大概讲给另一个工具听。这个办法能用,但很累,而且漏信息。真正关键的信息往往不在最后一段回复里,而在某个 tool result、某次 git status、某个 compact summary,或者一次失败的命令输出里。
所以我干脆把这件事变成了一个工作流。具体做法不是改 Claude 或 Codex 的源码,而是给它们各自配一层本地 skill:当我发出某种固定格式的 resume 指令时,Agent 不把它当普通 shell 命令,而是按约定去读另一个工具留下的 session 日志。
我故意沿用了真实 CLI 的形式。比如 claude --resume SESSION_ID 本来就是 Claude CLI 的命令,但在 Codex 对话里,我想表达的不是“请执行这个命令”,而是“请按 Claude 的 sessionId 去接手这个任务”。这样不用再记一套新的暗语,平时怎么想,就怎么发。
当我在 Codex 里发:
claude --resume xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx
它不会真的去执行 claude --resume。它会把这句话理解成:去 ~/.claude 里找这个 session 相关的记录,读完以后继续做 Claude 没完成的事。
反过来也一样。我在 Claude 里发:
codex resume xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx
Claude 会去读 Codex 的 session 记录,然后接着干。
Skill 做了什么
我给 Codex 做了一个 claude-resume skill。它不是一个复杂脚本,更像一份很明确的工作说明。精简以后大概是这样:
When the user sends `claude --resume SESSION_ID`,
treat it as an instruction to continue the previous Claude Code task,
not as a shell command.

Find the related Claude session records under ~/.claude.
Read the full conversation context, tool calls, tool results,
errors, summaries, and final records.

Then check the current repository state before continuing.
实际流程更具体一点:
- 看到
claude --resume SESSION_ID,不要当 shell 命令执行 - 先从命令里提取 sessionId
- 去 Claude 的本地记录里找到相关 session
- 读用户消息、助手回复、工具调用、工具结果、总结、错误和最后状态
- 从记录里总结任务、已完成部分、失败点
- 回到当前仓库跑
git status、git log、必要的 diff - 确认当前 worktree 状态以后,再继续干活
定位 session 文件
Claude 的记录在:
~/.claude/projects/**/<sessionId>.jsonl
~/.claude/sessions/*.json
~/.claude/history.jsonl
Codex 的记录在:
~/.codex/sessions/YYYY/MM/DD/rollout-...-<sessionId>.jsonl
~/.codex/history.jsonl
SESSION_ID 不在手边的话,可以用 find 按时间排序翻最近几个,或者用 rg 按工作目录和任务描述搜。
解析 JSONL
两个工具的 session 文件都是 JSONL,每行一个 JSON 对象。我这里看到的 Codex 格式里,payload.type 大概有这几类:user_message(用户输入)、message(助手回复)、function_call / function_call_output(工具调用和结果)、task_complete(任务结束)。Claude 那边格式类似,字段名略有不同。
Claude 这边的 codex-resume skill 里有一段 Python 脚本,专门从 JSONL 里提取关键信息:最近的用户消息、最后的助手回复、最后几次工具调用和输出、最后一次 git status 输出。Codex 这边的 claude-resume skill 更简单,是一份 prompt 工作说明,让 Agent 自己去翻 ~/.claude 的记录。
断点摘要
读完日志之后,skill 要求 Agent 先输出这个结构的断点摘要:
【任务背景】从用户消息提炼的目标
【已完成】有工具结果证明的部分
【中断原因】usage limit / 用户关闭 / 其他
【最后未被执行的指令】最后一条用户消息(如有)
【建议下一步】最紧迫的一件事
先输出断点摘要,再检查当前仓库状态,然后继续。这样即使 Agent 对日志的理解有偏差,也有机会在动手前校准。
这里最重要的一条是:记录里的最后状态不一定等于现在的状态。同一个任务可能已经被另一个 session 接着做过了,或者我自己在中间改过代码。接手时如果只相信旧记录,很容易重复做、覆盖别人改动,或者把已经修好的东西当成还没修。
所以 resume 的流程不是读日志然后照着日志继续,而是读日志,还原意图和停点,再用当前仓库状态校准一次。
双向接手
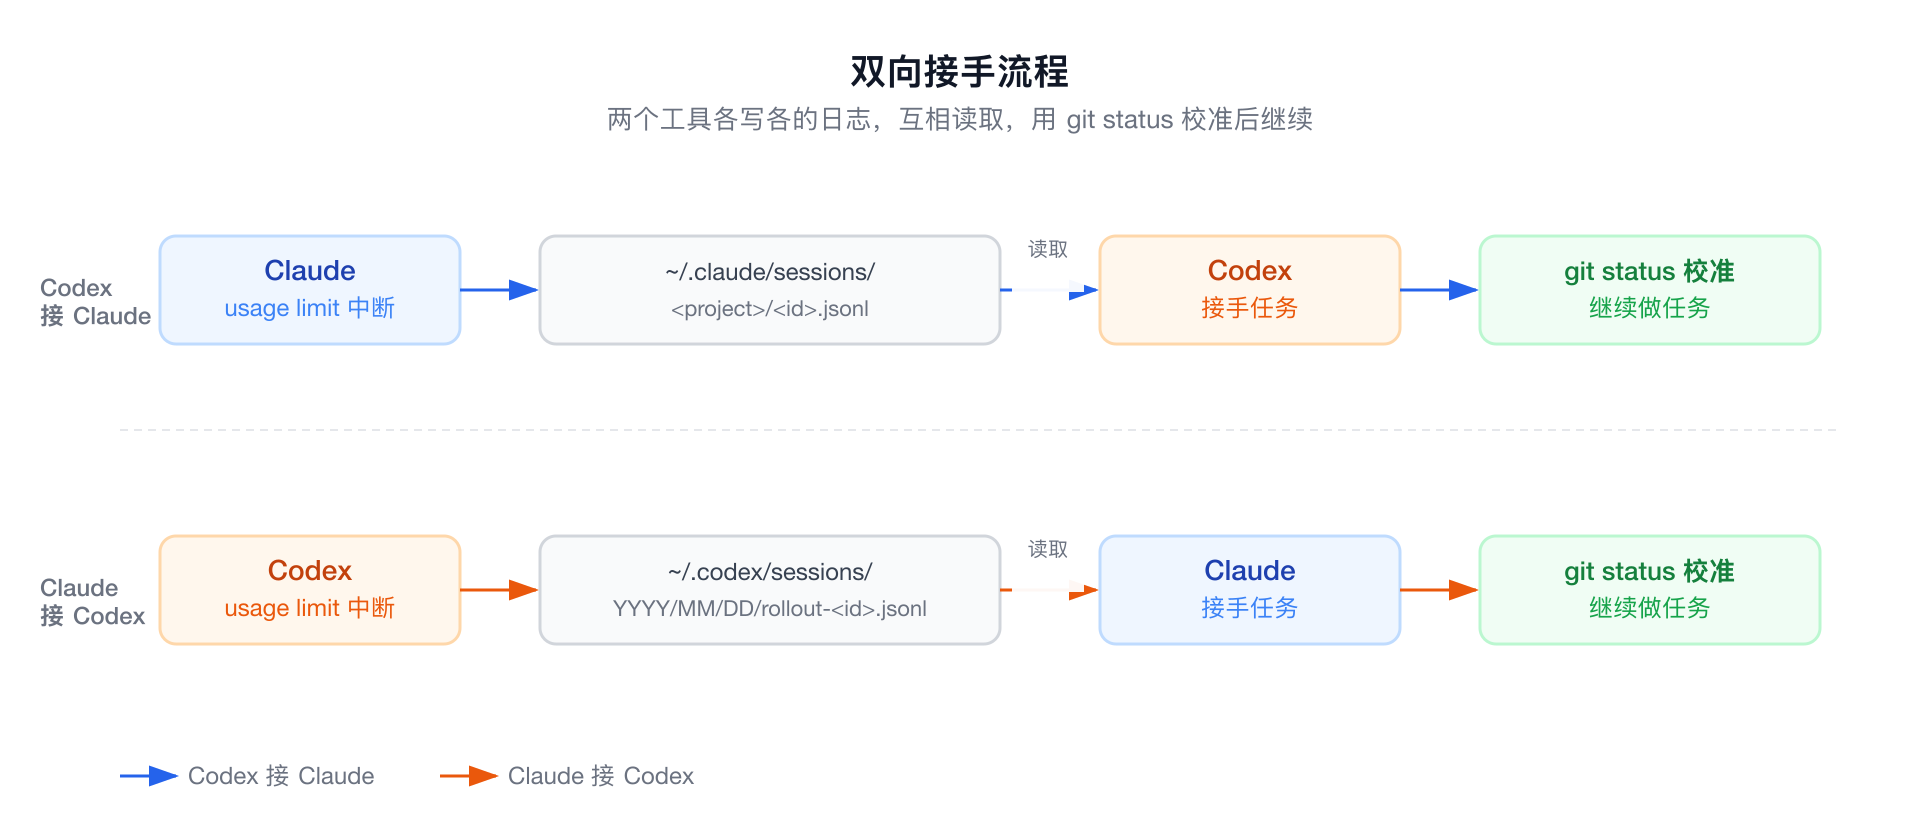
上面是两条流程。蓝色:Claude 的 5h 窗口用完,在 Codex 里发 claude --resume ID,Codex 去读 ~/.claude/sessions/ 的记录,校准 git 状态后继续。橙色反过来:Codex 中断,在 Claude 里发 codex resume ID,Claude 去读 ~/.codex/sessions/ 的记录,同样先 git status 再动手。两边各写各的日志,只是约定了一套读对方记录的方式。
几个坑
不能只看索引或最后几行。索引只能定位,真正有用的是完整 session 过程——很多关键事实在中间,比如用户后来否掉了一个方案,或者明确要求某些本地配置不要写进项目里。
不能无脑相信旧状态。接手之前一定要看当前 git status。记录只能说明当时发生了什么,不能保证现在的文件系统还是那个状态。
工具结果比助手回复更重要。助手可能会说“我准备做 X”,但工具结果才告诉你 X 到底有没有成功。
resume 不是重放历史。它只是为了恢复任务意图和执行状态。真正继续做的时候,还是要按当前文件系统和 git 状态来。
我觉得值得写下来的点
这件事本身不复杂,说到底就是读 session、读 history、再看 git 状态。
AI 工具的迭代,现在快到很难对任何具体工具有长期依赖。今天在用的 Claude Code 和 Codex,半年后可能已经不是这个形态了,也可能被新的东西代替。绑死在某个工具的具体功能或文件路径上,是最容易被更新换代淘汰的那种用法。
重要的不是某条命令或某个文件路径,而是背后的判断:上下文可以传递,工具可以切换。这个判断不依附于任何一个具体工具。
Claude 没油了,就让 Codex 接。Codex 需要切走,就让 Claude 接。现在只是我自己用 skill 把这件事串起来,以后也许会有更好的官方实现。重要的是这种用法:灵活一点,把 AI 当成可以接力的工具,而不是把一个任务锁死在一个会话里。